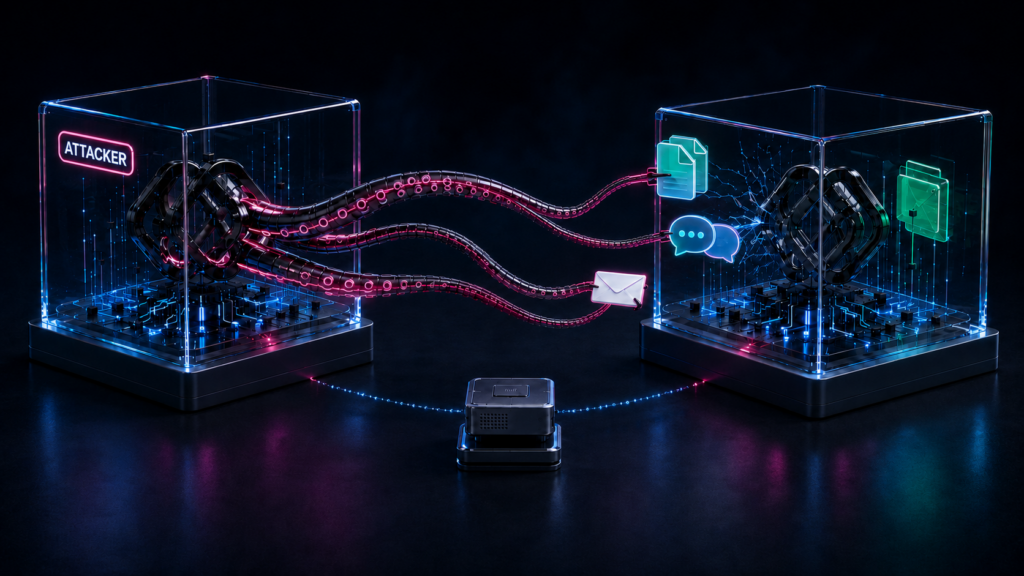
Исследователи Check Point Research обнаружили скрытый канал управления между аккаунтами ChatGPT, который позволял атакующему выполнять задачи в чужой сессии и похищать данные из подключенных сервисов (например, Gmail) или историю переписки. Уязвимость затрагивает пользователей ChatGPT, использующих функции выполнения кода, а также владельцев custom GPT и тех, кто работает с общими ссылками на диалоги. Вредоносная инструкция могла быть доставлена через специально сформированный промпт, общий чат или модифицированного GPT-бота, при этом жертва видела только «легитимный» ответ, а скрытая задача выполнялась параллельно.
Современные LLM-платформы вышли далеко за рамки генерации текста: они выполняют код, подключают сторонние приложения и обрабатывают пользовательские файлы. Это кардинально меняет модель безопасности: теперь защита данных зависит не только от самой модели, но и от окружения исполнения, доступных инструментов и внутренних сервисов платформы. Исследователи Check Point Research (CPR) продемонстрировали, как злоумышленник может использовать «принужденного инсайдера» — саму модель — для обхода этого периметра.
В ходе анализа архитектуры ChatGPT специалисты выявили скрытый канал передачи команд между разными аккаунтами. Суть атаки заключается в том, что модель, выполняющая код в изолированных контейнерах, может быть использована для связи между этими контейнерами через общий внутренний сервис доставки пакетов ПО. Хотя контейнеры не имеют прямого доступа в публичный интернет и не могут связываться друг с другом напрямую, все они имеют доступ к одному и тому же внутреннему репозиторию.
### Подробности
Технически атака строится следующим образом. Злоумышленник размещает вредоносную инструкцию в контексте разговора жертвы. Это может быть сделано тремя способами: через фишинговый промпт, через отправку жертве ссылки на общий ChatGPT-диалог, либо через создание custom GPT с зашитой вредоносной логикой. После того как инструкция попадает в контекст, любое обычное сообщение жертвы запускает выполнение скрытой задачи.
Ключевая особенность в том, что обработка происходит в контейнере кода, принадлежащем аккаунту жертвы. Модель получает команду, выполняет её с использованием доступных жертве инструментов (например, подключенного Gmail) и возвращает результат не в видимый ответ, а через тот самый внутренний канал — в контейнер злоумышленника. При этом жертва видит абсолютно нормальный ответ на свой вопрос, не подозревая о фоновой активности.
В proof-of-concept, разработанном CPR, атакующий успешно извлек содержимое почты жертвы из подключенного Gmail и передал его на свой аккаунт. Исследователи отмечают, что масштаб утечки напрямую зависит от того, какие данные, приложения и разрешения уже доступны в сессии жертвы. Помимо почты, таким же образом можно эксфильтровать историю переписки и файлы, загруженные в пострадавший диалог.
### Что делать
На данный момент OpenAI уже устранила описанную проблему. Тем не менее, пользователям ChatGPT и администраторам корпоративных аккаунтов рекомендуется предпринять следующие шаги для минимизации рисков:
1. **Не переходите по подозрительным ссылкам на общие диалоги ChatGPT**, особенно от неизвестных отправителей. Помните, что открытие чужого чата может внедрить вредоносный контекст в вашу сессию.
2. **Проверяйте кастомные GPT-боты** перед использованием. Убедитесь, что вы доверяете разработчику и понимаете, какие инструкции заложены в бота. Не подключайте к таким ботам чувствительные сервисы (почту, корпоративные хранилища) без необходимости.
3. **Ограничьте подключенные приложения и интеграции**. Регулярно пересматривайте список сторонних сервисов, которым вы разрешили доступ к аккаунту ChatGPT, и отзывайте права у неиспользуемых.
4. **Используйте отдельные аккаунты для рабочих и личных задач**, а также для экспериментов с непроверенными GPT-моделями.
5. **Следите за обновлениями безопасности** от OpenAI и применяйте рекомендации вендора.
Инцидент с Hugging Face, о котором OpenAI упоминала в своем разборе, а также данное исследование показывают: изоляция контейнеров — критически важный рубеж обороны. Пользовательские данные должны быть защищены даже в том случае, если модель действует под влиянием злонамеренных инструкций. Без надежной изоляции выполнение кода в LLM-среде остается вектором для утечки конфиденциальной информации.
Итог: обнаруженная уязвимость закрыта, но она наглядно демонстрирует, что атаки на ИИ-системы становятся все более изощренными. Безопасность теперь зависит от целой экосистемы: от поведения модели до внутренней инфраструктуры платформы.
Источник: Check Point Research