

Слой учетных данных растет быстрее, чем службы ИБ успевают его контролировать
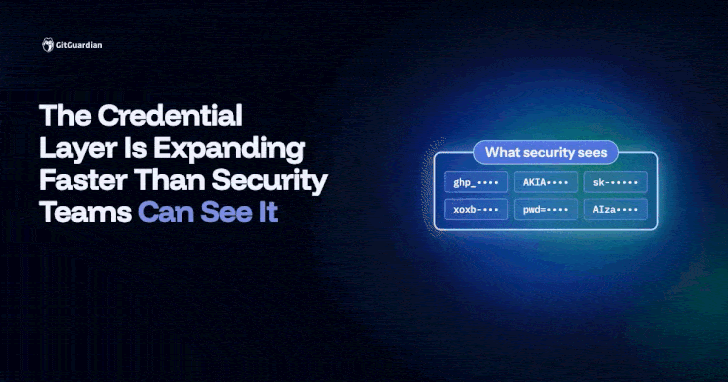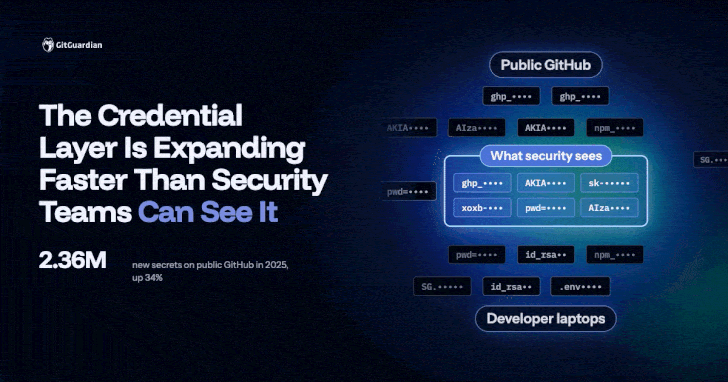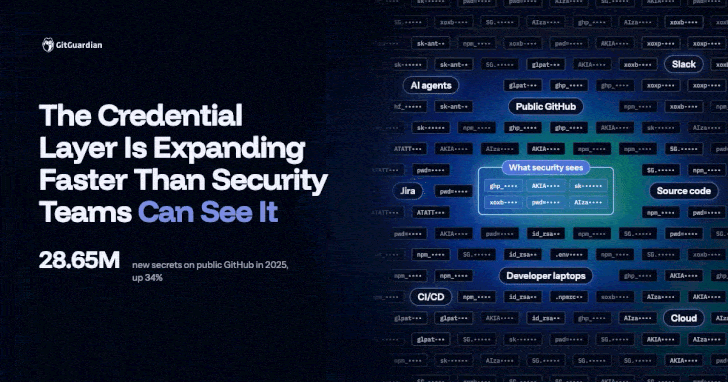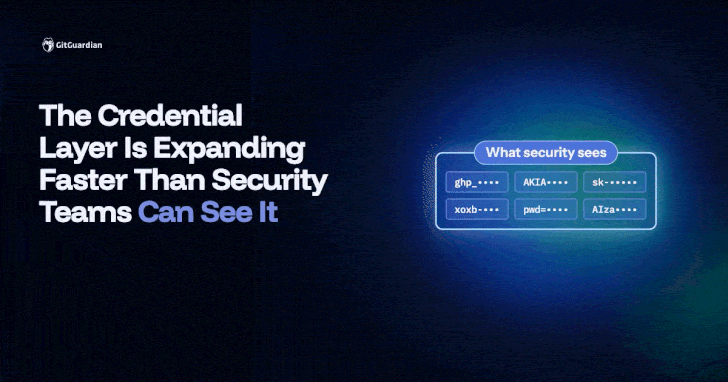
Современное предприятие целиком зависит от учетных данных: именно через них люди, системы и теперь ИИ безопасно подключаются к данным, сервисам и друг к другу. Компания GitGuardian предлагает защищать этот слой с помощью трех связанных возможностей — Detect, Remediate и Prevent. Путь начинается с обнаружения, поскольку организации сначала должны понять, какие учетные данные существуют, где они хранятся и что с ними происходит.
Подробности
GitGuardian помогает защищать этот слой через три связанные между собой возможности: Detect, Remediate и Prevent — обнаружение, устранение и предотвращение. Логика здесь выстроена последовательно: путь начинается именно с обнаружения, потому что организации сначала должны понять, какие учетные данные существуют, где они находятся и что с ними происходит. Без этого этапа невозможно ни оценить реальную поверхность атаки, ни выстроить эффективное реагирование. Проблема в том, что слой учетных данных перестал быть статичным. Раньше речь шла в основном о паролях и ключах доступа в коде и конфигурациях. Сегодня к ним добавляются токены API, секреты CI/CD, ключи облачных сервисов, сертификаты, а также учетные данные, которыми пользуются AI-агенты и автоматизированные системы. Каждый новый сервис, каждая новая интеграция добавляют новые точки, где могут оказаться незащищенные или забытые секреты. При этом видимость этих активов у команд безопасности зачастую ограничена: секреты распределены по репозиториям, пайплайнам, облачным средам и сторонним платформам. Именно поэтому обнаружение становится фундаментом. Организация не может устранить то, о существовании чего не знает, и не может предотвратить утечку, если не понимает, где именно хранятся ее секреты и кто имеет к ним доступ. Расширение слоя учетных данных означает, что традиционные подходы — разовые аудиты, ручной поиск, разрозненные сканеры — уже не дают нужного покрытия. В материале не приводятся конкретные версии продуктов, идентификаторы CVE или данные об отдельных инцидентах. Речь идет о системной тенденции: масштаб и сложность credential-слоя растут быстрее, чем инструменты и процессы, призванные держать его под контролем.Что делать
Исходя из логики Detect — Remediate — Prevent, организациям стоит выстроить работу с учетными данными как с непрерывным процессом, а не разовой задачей. Во-первых, обеспечить постоянное обнаружение секретов. Сканирование должно охватывать репозитории, историю коммитов, CI/CD-пайплайны, конфигурации и облачные среды — то есть все места, где вообще могут оказаться учетные данные. Во-вторых, наладить управление жизненным циклом секретов: своевременный отзыв и ротацию скомпрометированных или устаревших ключей, ограничение их срока жизни и области применения, отказ от долгоживущих статических credentials там, где возможны краткосрочные. В-третьих, смещать фокус в сторону предотвращения: внедрять практики, при которых секреты не попадают в код и конфигурации изначально, а также использовать средства контроля на этапе разработки и развертывания. Отдельное внимание стоит уделить новым участникам — AI-агентам и автоматизированным системам, которые тоже нуждаются в учетных данных и доступах. Их секреты должны попадать в общий контур обнаружения и управления на тех же правах, что и «классические» ключи и пароли. Итог: слой учетных данных расширяется вместе с инфраструктурой, и без постоянной видимости всех секретов организация неизбежно теряет контроль над своей поверхностью атаки. Обнаружение — не финальный шаг, а обязательная отправная точка для устранения и предотвращения угроз.Источник: The Hacker News